DroneCATS:评测多模态大模型作为无人机通用视觉-语言-动作智能体
DroneCATS-Agent是一种架构,其中多模态大型语言模型(MLLM)是可替换的组件。DroneCATS是一个基准,将模型视为独立变量。该研究评估了前沿和开放模型在四个核心能力方面的表现,包括接近可见目标、跟踪移动
共为你整理相关教程、经验与问题解答。
DroneCATS-Agent是一种架构,其中多模态大型语言模型(MLLM)是可替换的组件。DroneCATS是一个基准,将模型视为独立变量。该研究评估了前沿和开放模型在四个核心能力方面的表现,包括接近可见目标、跟踪移动
StudentSim是一种基于LLM的学生模拟器训练框架,旨在通过整合学生数据,生成个性化的模拟器。该框架能够模仿学生的回答,并在导师指导下更新这些回答。StudentSimEval是一个标准化评估协议,涵盖60名学生在
H3-World是一个高效的框架,将33B的MiniMax-H3视频生成器转化为一个交互式世界模型。研究发现,随着大型视频生成器能力的提升,语言正成为控制的自然接口。MiniMax-H3已支持通过自然语言指令实现角色行为

UC Berkeley 等机构发布了 Vero 基准,旨在检验 AI 智能体在构建形式化验证的完整软件仓库方面的能力。Vero 包含 43 个多模块 Lean 4 实例,要求智能体在仓库级别同时编写实现和证明。评估结果显
Databricks官方博客发布了《Big Book of AgentOps》,该书将AgentOps定义为构建、部署和运营智能体的操作规范,旨在指导AI智能体的工程实践。以下是该书的三个要点: 1. AgentOps是
Hefei AiDA Lab 等机构的研究者提出了一套评估框架,旨在将 LLM 防护评测结果转换为部署安全结论。通过对 198 篇论文的分析,发现152个宽编码声明中只有108个建立了正向残余有害协助,没有一个建立零残余
澳大利亚律所 Gilbert + Tobin 通过 ChatGPT Enterprise 和 Codex 将 AI 融入运营,截至 2026 年 6 月 87% 的启用席位处于活跃使用状态,是其其他工具采用率的两倍以上。
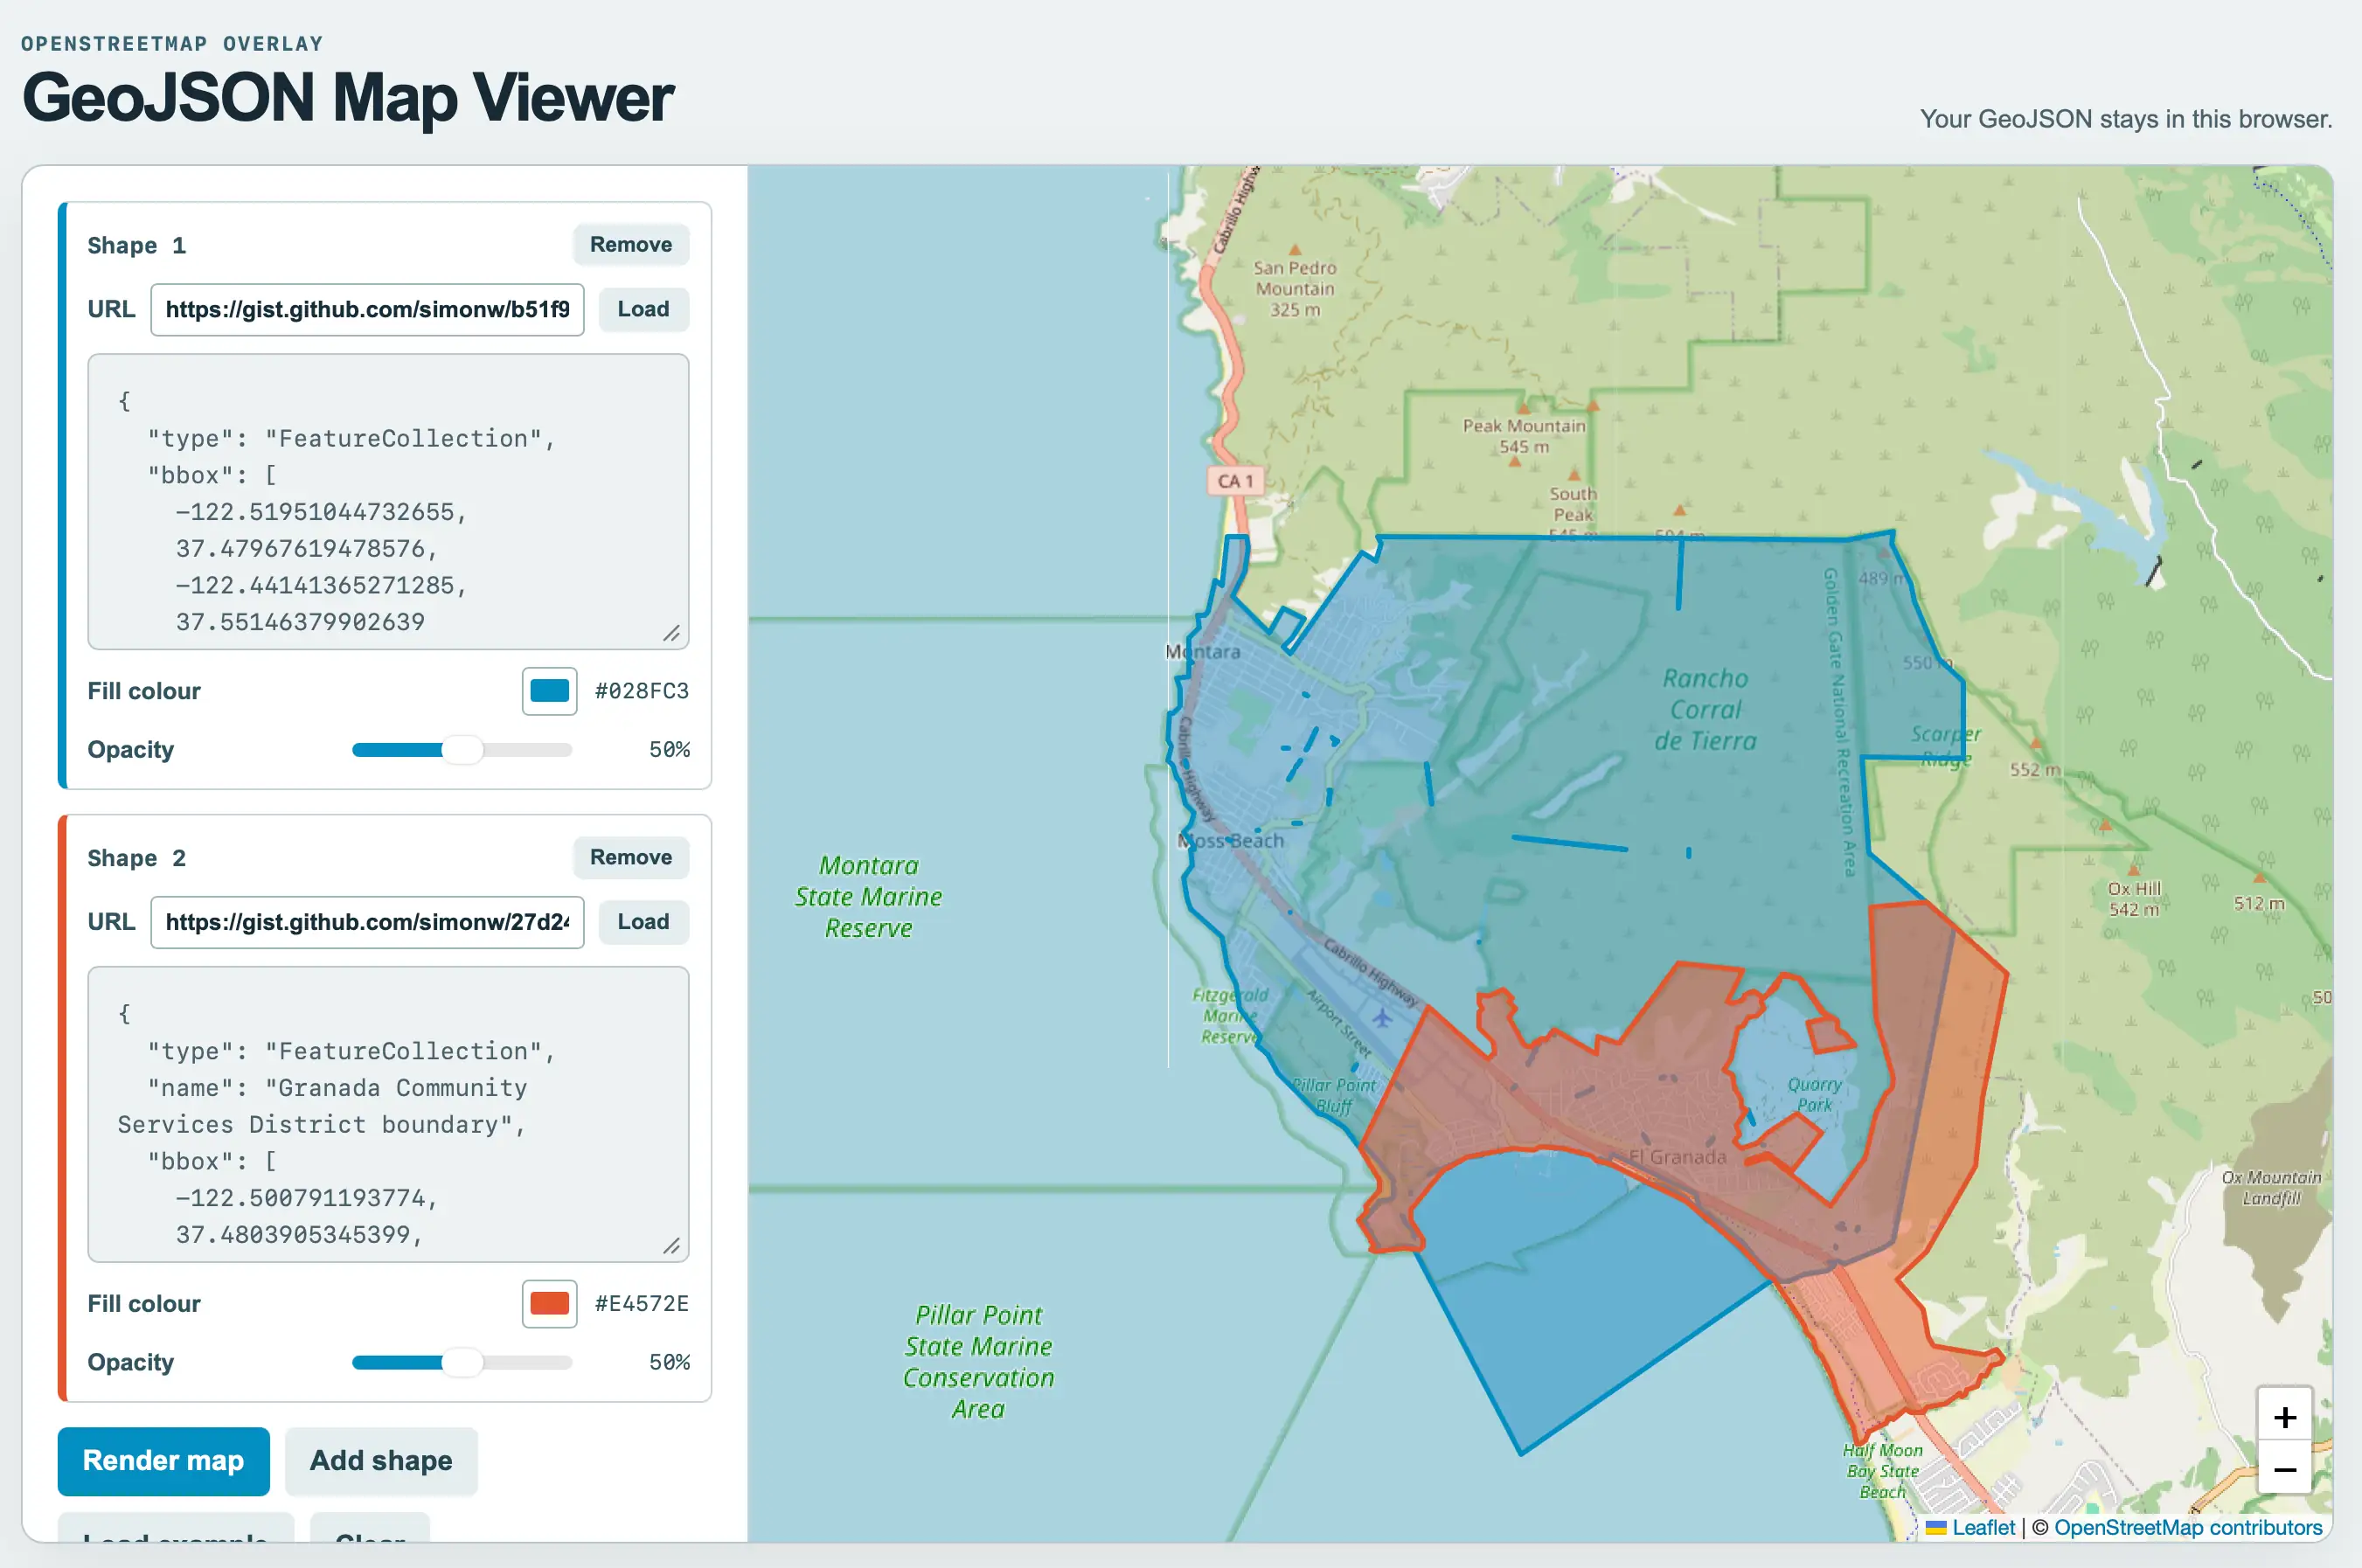
Simon Willison在帮助Natalie收集地方政治边界地图时,发现需要展示GeoJSON文件并在地图上导出为PNG格式。他向GPT-5.6-Sol寻求工具建议,并主动构建了一个工具。经过使用Claude Cod
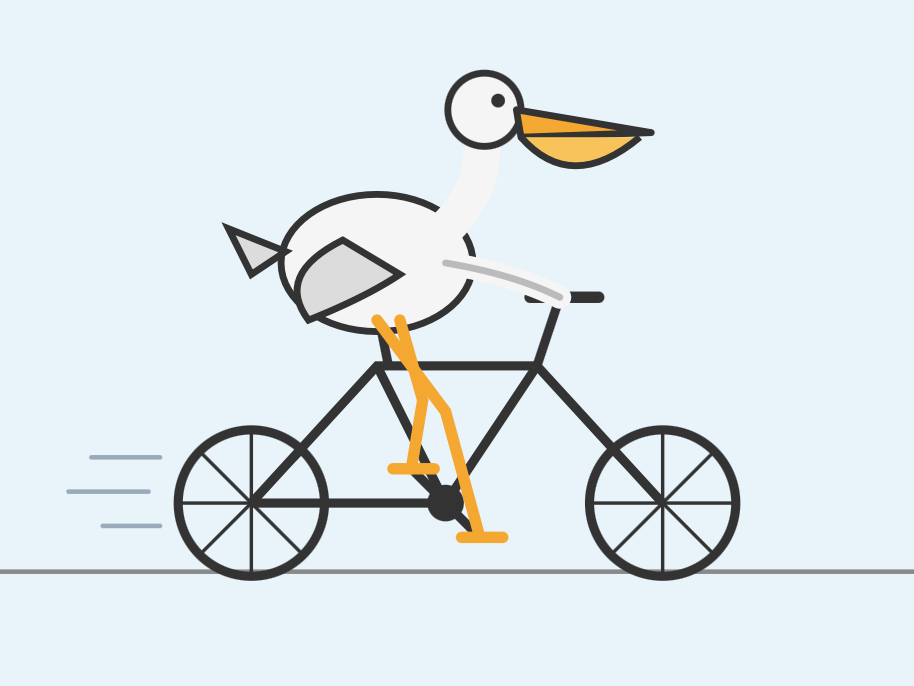
Simon Willison在其博客中实测了Anthropic的Claude Fable 5.1模型在不同推理档位下的表现。Fable 5.1具有五个推理档位:低、中、高、x高和最大。Willison发现,在低和中档位时

概述:谷歌正积极与好莱坞片厂洽谈AI版权授权,希望通过训练AI模型获得大量资金。虽然这些交易对谷歌有利,但片厂面临的风险较高,包括可能损害公众对娱乐产业的信任,以及AI技术可能导致的就业问题。 要点: 1. 谷歌寻求与好